教程:VENTUNO Q/实时人脸检测
概述
本教程将在 Arduino® VENTUNO™ Q 上运行实时人脸检测演示,使用来自 Qualcomm® AI Hub 的 face_det_lite(轻量级人脸检测)模型。该模型经过量化,完全在开发板 Qualcomm® Dragonwing™ QCS8275 处理器的 Qualcomm® Hexagon™ NPU 上运行。
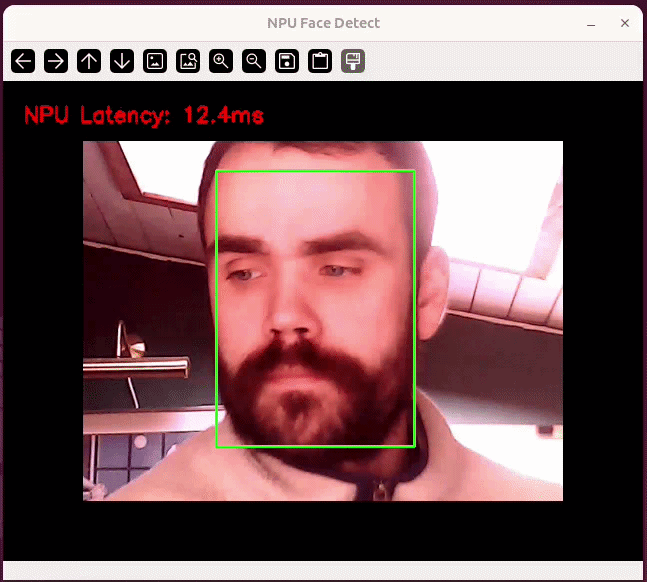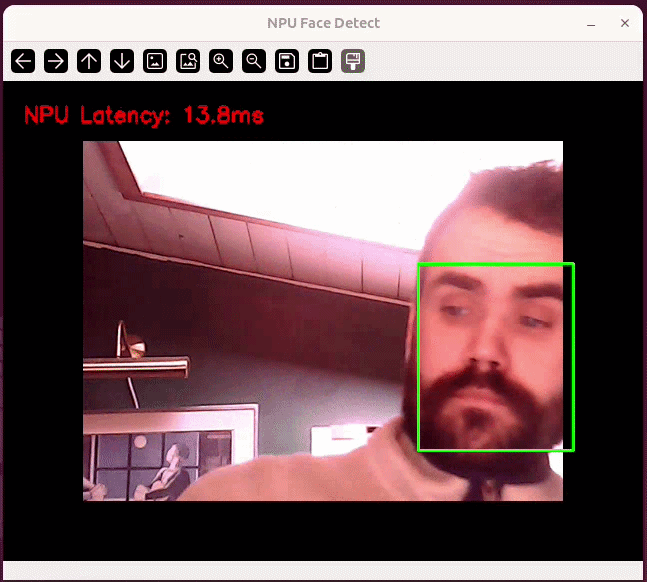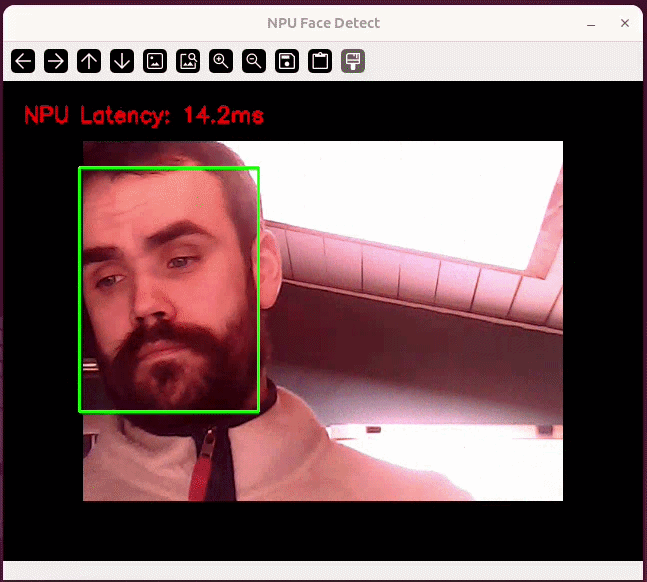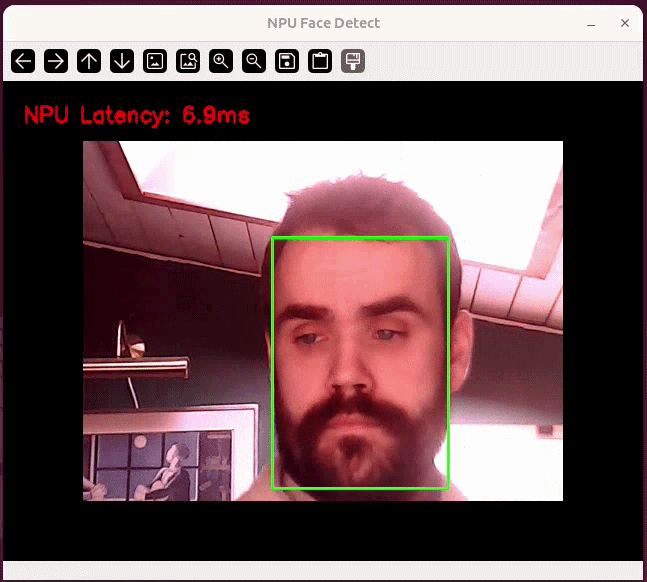
该演示是一个独立的 Python 脚本(face_detection_camera.py),从 USB 相机读取画面,逐帧检测每张人脸,并实时叠加边界框。
本指南将涵盖:
- 为 VENTUNO Q 供电并访问开发板。
- 设置 Python 虚拟环境。
- 直接在开发板上下载模型文件。
- 在 CPU 与 NPU 上运行人脸检测演示。
硬件与软件要求
硬件
- Arduino® VENTUNO™ Q
- Arduino® USB-C Power Supply (65W),或通过电源圆口接入 7–24 V 直流电源
- 连接到 USB-A 口的 USB 相机,设备路径为
/dev/video0 - 连接到开发板的显示器、键盘和鼠标\*(脚本会在屏幕上打开实时窗口)
说明:
将 VENTUNO Q 用作 SBC 时,鼠标并非必需(但会更方便)。
软件
- 主机上可用的
adb(Android® Platform Tools)或ssh - Python 3.12(已预装在 VENTUNO Q 上)
警告:
必须先用电源为 VENTUNO Q 供电,然后再用 USB-C® 线缆连接主机,否则开发板可能崩溃。建议使用功率至少 65 W、电压范围 7–24 V 的电源。
访问开发板 Shell
在开发板通过电源圆口供电后,可使用 adb 或 ssh 访问 VENTUNO Q 上的 shell(终端)。
要通过 adb 连接,用 USB-C® 线缆连接 VENTUNO Q 与电脑,然后运行:
# Using adb (Android Debug Bridge)
adb shell
要通过 ssh 连接,请确保 VENTUNO Q 与电脑连接到同一网络,然后运行:
# Using ssh (Secure Shell)
ssh arduino@<ip-address>
若不知道开发板的 IP 地址,可连接键盘和显示器并在开发板上运行 hostname -I,或先用 sudo nmtui 配置 Wi-Fi®。
说明:
有关远程访问开发板的更多方式,请参阅 Remote Access 教程。
警告:
由于此演示会在屏幕上打开实时相机窗口,请在开发板的实际桌面会话中运行(物理显示器与键盘,或进入开发板的 VNC/X11 会话)。
adb与ssh仍是安装依赖并确认脚本可运行的最简便方式,然后再切换到桌面会话观看相机画面。
设置 Python 环境
本节中的所有命令都在 VENTUNO Q 上运行。
1. 创建虚拟环境
创建并激活 Python 虚拟环境以隔离依赖:
python3 -m venv ~/.venv
source ~/.venv/bin/activate
提示符中的 (.venv) 前缀表示环境已激活。每个新会话开始时请再次运行 source 命令。
2. 安装依赖
此演示需要 opencv-python、numpy 和 ai-edge-litert(后者捆绑了 TFLite 解释器以及用于 NPU 执行的 QNN HTP 委托加载器):
pip install ai-edge-litert==1.3.0 opencv-python numpy
NPU 执行还需要 QNN HTP 委托(libQnnTFLiteDelegate.so),由 Qualcomm® AI Runtime (QAIRT) 提供。它默认未安装,也不会被任何 pip 包拉取,因此请从开发板的 apt 仓库安装:
sudo apt update
sudo apt install qairt-libs qairt-dsp-binaries
继续之前请确认委托已存在:
ls /usr/lib/libQnnTFLiteDelegate.so
下载模型文件
除 Python 脚本外,演示还需要一个模型文件。你可以直接在开发板上下载并准备——无需从主机传输:
| 文件 | 说明 | 来源 |
|---|---|---|
face_det_lite-lightweight-face-detection-w8a8.tflite
|
量化人脸检测模型,在 NPU 上运行 | Qualcomm AI Hub |
首先,在开发板上创建并进入工作目录:
mkdir -p /home/arduino/face-detection
cd /home/arduino/face-detection
模型来自 Qualcomm AI Hub 上的 face_det_lite,通过 qai-hub-models CLI 获取。请先安装该工具(体积较大,可能需要一些时间),然后拉取量化精度版本:
pip install qai-hub-models

# Quantized precision -> extracts face_det_lite-tflite-w8a8/
qai-hub-models fetch face_det_lite -r tflite -p w8a8 -o .
这会解压出一个包含单个 face_det_lite.tflite 的 face_det_lite-tflite-w8a8/ 文件夹。与多阶段模型不同,这是单阶段模型,因此无需丢弃额外文件。将其重命名为脚本所期望的文件名:
cp face_det_lite-tflite-w8a8/face_det_lite.tflite ./face_det_lite-lightweight-face-detection-w8a8.tflite
完成此步骤后,/home/arduino/face-detection 目录中应包含 face_det_lite-lightweight-face-detection-w8a8.tflite。
警告:
qai-hub-models依赖ai-edge-litert>=2.0.2,因此安装它会升级你先前安装的ai-edge-litert==1.3.0。2.x 版本无法与 QNN HTP 委托配合:委托会以Failed to validate op ... Conv2d拒绝每个卷积,并静默回退到 CPU,由于额外的委托开销,最终会比纯 CPU 执行更慢。拉取模型后,请将版本恢复为 1.3.0:
pip install ai-edge-litert==1.3.0
运行演示前,请确认处于可用版本:
pip show ai-edge-litert | grep Version # must report 1.3.0
说明:
pip会打印以ERROR:开头的一行,提示qai-hub-models需要更新的ai-edge-litert。降级仍然会成功,之后qai-hub-models fetch仍可使用,因此可忽略该消息。
或者,将 qai-hub-models 放在仅用于下载模型的单独虚拟环境中,而将演示环境固定为 ai-edge-litert==1.3.0。
创建脚本
在 VENTUNO Q 上,进入工作目录并创建脚本文件:
cd /home/arduino/face-detection
nano face_detection_camera.py
将下方 代码示例 一节中的完整脚本粘贴到编辑器中。在 nano 中,用 Ctrl+X,然后 Y,再按 Enter 保存并退出。
运行演示
在虚拟环境已激活且模型文件位于 /home/arduino/face-detection 的情况下,从开发板的桌面会话运行演示:
cd /home/arduino/face-detection
source ~/.venv/bin/activate            # if not already active

python3 face_detection_camera.py            # model on the CPU
python3 face_detection_camera.py --use-npu  # model on the Hexagon NPU
会打开标题为 "Face Detect" 的窗口,显示实时相机画面,并在每张检测到的人脸周围绘制绿色边界框。屏幕叠加层会报告模型 invoke 时间、往返时间(set + invoke + get tensor)以及每帧总延迟。在窗口中按 q 退出。
与 CPU 相比,在 NPU 上运行可明显降低 invoke 与往返延迟。
若从远程主机(adb 或 ssh)启动脚本,需要先允许其在显示器上渲染。
在开发板本地(不使用 adb 或 ssh)打开终端并运行以下命令:
xhost +
export DISPLAY=:0   # replace 0 with your display number
这将允许远程主机在显示器上运行应用程序。若不执行此步骤,从远程主机运行脚本时会出现与 xcb 相关的错误。
代码示例
下方给出完整、自包含的演示。请将其保存为工作目录中与模型文件同级的 face_detection_camera.py。
import numpy as np
import cv2
from ai_edge_litert.interpreter import Interpreter, load_delegate
import time
import sys

# --- SETUP ---
MODEL_PATH = 'face_det_lite-lightweight-face-detection-w8a8.tflite'
use_npu = True if len(sys.argv) >= 2 and sys.argv[1] == '--use-npu' else False

experimental_delegates = []
if use_npu:
    experimental_delegates = [load_delegate("libQnnTFLiteDelegate.so", options={"backend_type": "htp"})]

interpreter = Interpreter(model_path=MODEL_PATH, experimental_delegates=experimental_delegates)
interpreter.allocate_tensors()

input_details  = interpreter.get_input_details()
output_details = interpreter.get_output_details()

_, M_H, M_W, M_C = input_details[0]['shape']
input_dtype = input_details[0]['dtype']
in_scale = float(input_details[0]['quantization'][0])
in_zp    = int(input_details[0]['quantization'][1])   # int() cast matches official code

# Confirm how many outputs the delegate sees
print(f"Number of outputs: {len(output_details)}")

# Pre-allocate reusable buffers
_canvas       = np.zeros((M_H, M_W, 3), dtype=np.uint8)
_input_tensor = np.zeros((1, M_H, M_W, 1), dtype=input_dtype)

# --- NPU WARMUP ---
if use_npu:
    print("Warming up NPU...")
    for _ in range(3):
        interpreter.set_tensor(input_details[0]['index'], _input_tensor)
        interpreter.invoke()
    print("Warmup done.")

class BBox:
    def __init__(self, xyrb, score, landmark=None):
        self.score    = score
        self.landmark = landmark
        x, y, r, b   = xyrb
        self.x = min(x, r)
        self.y = min(y, b)
        self.r = max(x, r)
        self.b = max(y, b)

    @property
    def width(self):  return self.r - self.x + 1
    @property
    def height(self): return self.b - self.y + 1
    @property
    def box(self):    return [self.x, self.y, self.r, self.b]
    @property
    def xywh(self):   return [self.x, self.y, self.width, self.height]

def get_iou(boxA, boxB):
    xA = max(boxA[0], boxB[0]);  yA = max(boxA[1], boxB[1])
    xB = min(boxA[2], boxB[2]);  yB = min(boxA[3], boxB[3])
    inter = max(0, xB - xA + 1) * max(0, yB - yA + 1)
    aA = (boxA[2]-boxA[0]+1) * (boxA[3]-boxA[1]+1)
    aB = (boxB[2]-boxB[0]+1) * (boxB[3]-boxB[1]+1)
    return inter / float(aA + aB - inter + 1e-6)

def nms(objs, iou_thresh=0.5):
    if not objs:
        return []
    objs  = sorted(objs, key=lambda o: o.score, reverse=True)
    flags = [0] * len(objs)
    keep  = []
    for i, obj in enumerate(objs):
        if flags[i]:
            continue
        keep.append(obj)
        for j in range(i + 1, len(objs)):
            if flags[j] == 0 and get_iou(np.array(obj.box), np.array(objs[j].box)) > iou_thresh:
                flags[j] = 1
    return keep

def detect(hm, box, landmark=None, threshold=0.4, nms_iou=0.3, stride=8):
    """
    Postprocessing matching the official AI Hub implementation:
      - sigmoid heatmap
      - 3x3 max-pool local-maxima suppression
      - top-2000 candidates
      - NMS
    """
    hm_hw = 1.0 / (1.0 + np.exp(-np.clip(hm[..., 0].astype(np.float32), -15, 15)))

    # 3x3 max-pool, same padding — mirrors torch F.max_pool2d(kernel=3, stride=1, padding=1)
    H, W = hm_hw.shape
    xpad = np.pad(hm_hw, 1, mode='constant', constant_values=-np.inf)
    s0, s1 = xpad.strides
    windows  = np.lib.stride_tricks.as_strided(
        xpad, shape=(H, W, 3, 3), strides=(s0, s1, s0, s1), writeable=False
    )
    hm_pool  = windows.max(axis=(2, 3))

    candidate_scores = np.where(hm_hw >= hm_pool, hm_hw, 0.0).ravel()

    k = min(int((hm_hw >= hm_pool).sum()), 2000)
    if k == 0:
        return []
    idx_part = np.argpartition(-candidate_scores, k - 1)[:k]
    order    = np.argsort(-candidate_scores[idx_part])
    flat_idx = idx_part[order]
    scores_k = candidate_scores[flat_idx]

    ys = (flat_idx // W).astype(np.int32)
    xs = (flat_idx %  W).astype(np.int32)

    objs = []
    for cx, cy, score in zip(xs, ys, scores_k):
        if score < threshold:
            break  # sorted desc — safe to break early

        x, y, r, b = box[cy, cx].astype(np.float32)
        xyrb = [
            int((cx - x) * stride),
            int((cy - y) * stride),
            int((cx + r) * stride),
            int((cy + b) * stride),
        ]

        lm = None
        if landmark is not None:
            x5y5  = landmark[cy, cx].astype(np.float32)
            x5y5 += np.array([cx]*5 + [cy]*5, dtype=np.float32)
            x5y5 *= float(stride)
            lm = list(zip(x5y5[:5].tolist(), x5y5[5:].tolist()))

        objs.append(BBox(xyrb, float(score), lm))

    return nms(objs, nms_iou)

def preprocess_frame(frame):
    """
    Letterbox + blue-channel extraction + quantization.
    Matches official AI Hub preprocessing exactly.
    """
    h, w = frame.shape[:2]
    f_scale = min(M_W / w, M_H / h) * 0.75
    nw, nh  = int(w * f_scale), int(h * f_scale)

    scaled = cv2.resize(frame, (nw, nh))
    _canvas[:] = 0
    dx, dy = (M_W - nw) // 2, (M_H - nh) // 2
    _canvas[dy:dy+nh, dx:dx+nw] = scaled

    # Blue channel 0..1  (official code: img_array / 255.0, then take index [:,:,:,-1])
    blue = _canvas[:, :, 0].astype(np.float32) / 255.0

    # Quantize using int(zp) — matches official load_image_litert exactly
    if in_scale != 0.0:
        q = np.rint(blue / in_scale) + in_zp
        if input_dtype == np.uint8:
            _input_tensor[0, :, :, 0] = np.clip(q, 0, 255).astype(np.uint8)
        else:
            _input_tensor[0, :, :, 0] = np.clip(q, -128, 127).astype(np.int8)
    else:
        _input_tensor[0, :, :, 0] = blue

    return _canvas.copy()

def process_frame(frame):
    debug_canvas = preprocess_frame(frame)

    t_set = time.perf_counter()
    interpreter.set_tensor(input_details[0]['index'], _input_tensor)
    set_ms = (time.perf_counter() - t_set) * 1000

    t_invoke = time.perf_counter()
    interpreter.invoke()
    invoke_ms = (time.perf_counter() - t_invoke) * 1000

    t_get = time.perf_counter()

    def dequant(idx):
        s, z = output_details[idx]['quantization']
        return (interpreter.get_tensor(output_details[idx]['index']).astype(np.float32) - float(z)) * float(s)

    hm  = dequant(0)[0]
    box = dequant(1)[0]
    lm  = dequant(2)[0] if len(output_details) >= 3 else None
    get_ms = (time.perf_counter() - t_get) * 1000

    infer_ms   = set_ms + invoke_ms + get_ms
    detections = detect(hm, box, lm, threshold=0.4, nms_iou=0.3, stride=8)
    return detections, debug_canvas, infer_ms, invoke_ms

# --- MAIN LOOP ---
mode = "NPU" if use_npu else "CPU"
cap  = cv2.VideoCapture(0)

while True:
    ret, frame = cap.read()
    if not ret:
        break

    t_start = time.perf_counter()
    detections, debug_canvas, infer_ms, invoke_ms = process_frame(frame)
    total_ms = (time.perf_counter() - t_start) * 1000

    for det in detections:
        x, y, w, h = det.xywh
        cv2.rectangle(debug_canvas, (x, y), (x+w, y+h), (0, 255, 0), 2)
        if det.landmark:
            for (lx, ly) in det.landmark:
                cv2.circle(debug_canvas, (int(lx), int(ly)), 2, (0, 128, 255), -1)

    label = (f"{mode}  invoke={invoke_ms:.1f}ms  "
             f"round-trip={infer_ms:.1f}ms  total={total_ms:.1f}ms")
    cv2.putText(debug_canvas, label, (20, 40),
                cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 0, 255), 2)

    cv2.imshow('Face Detect', debug_canvas)
    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()
工作原理
- 预处理。 每一帧在保持宽高比的情况下缩放并居中放置在带填充的画布上,然后仅提取蓝色通道并量化为模型的输入张量——这与官方 AI Hub 参考实现使用的预处理完全一致。
- 后处理。 模型输出热力图与框回归图。热力图经 sigmoid 处理,再用 3×3 max-pool 识别局部极大值(对应
torch.nn.functional.max_pool2d,kernel=3, stride=1, padding=1)。按分数取前 2000 个候选,利用框图与模型 stride 解码为边界框,经分数阈值过滤,再用非极大值抑制(NMS)得到每张人脸一个框。 - 延迟分解。 屏幕叠加层将
invoke(NPU/CPU 推理调用本身)与round-trip(set tensor + invoke + get tensor)分开显示,便于区分总帧时间中有多少来自模型调用、有多少来自张量编组。
总结
在本教程中,你配置了 VENTUNO Q,下载了 face_det_lite 模型文件,并运行了在 Qualcomm® Hexagon™ NPU 上加速的实时人脸检测独立 Python 脚本。在此基础上,你可以直接在 Dragonwing™ QCS8275 处理器上利用检测到的边界框——例如裁剪人脸送入下游模型、统计画面中的人数,或在检测到人脸时触发事件。
原文:https://docs.arduino.cc/tutorials/ventuno-q/face-detection/ 本页为 Arduino 官方教程的中文翻译,供内部查阅。命令与代码保持原文。

